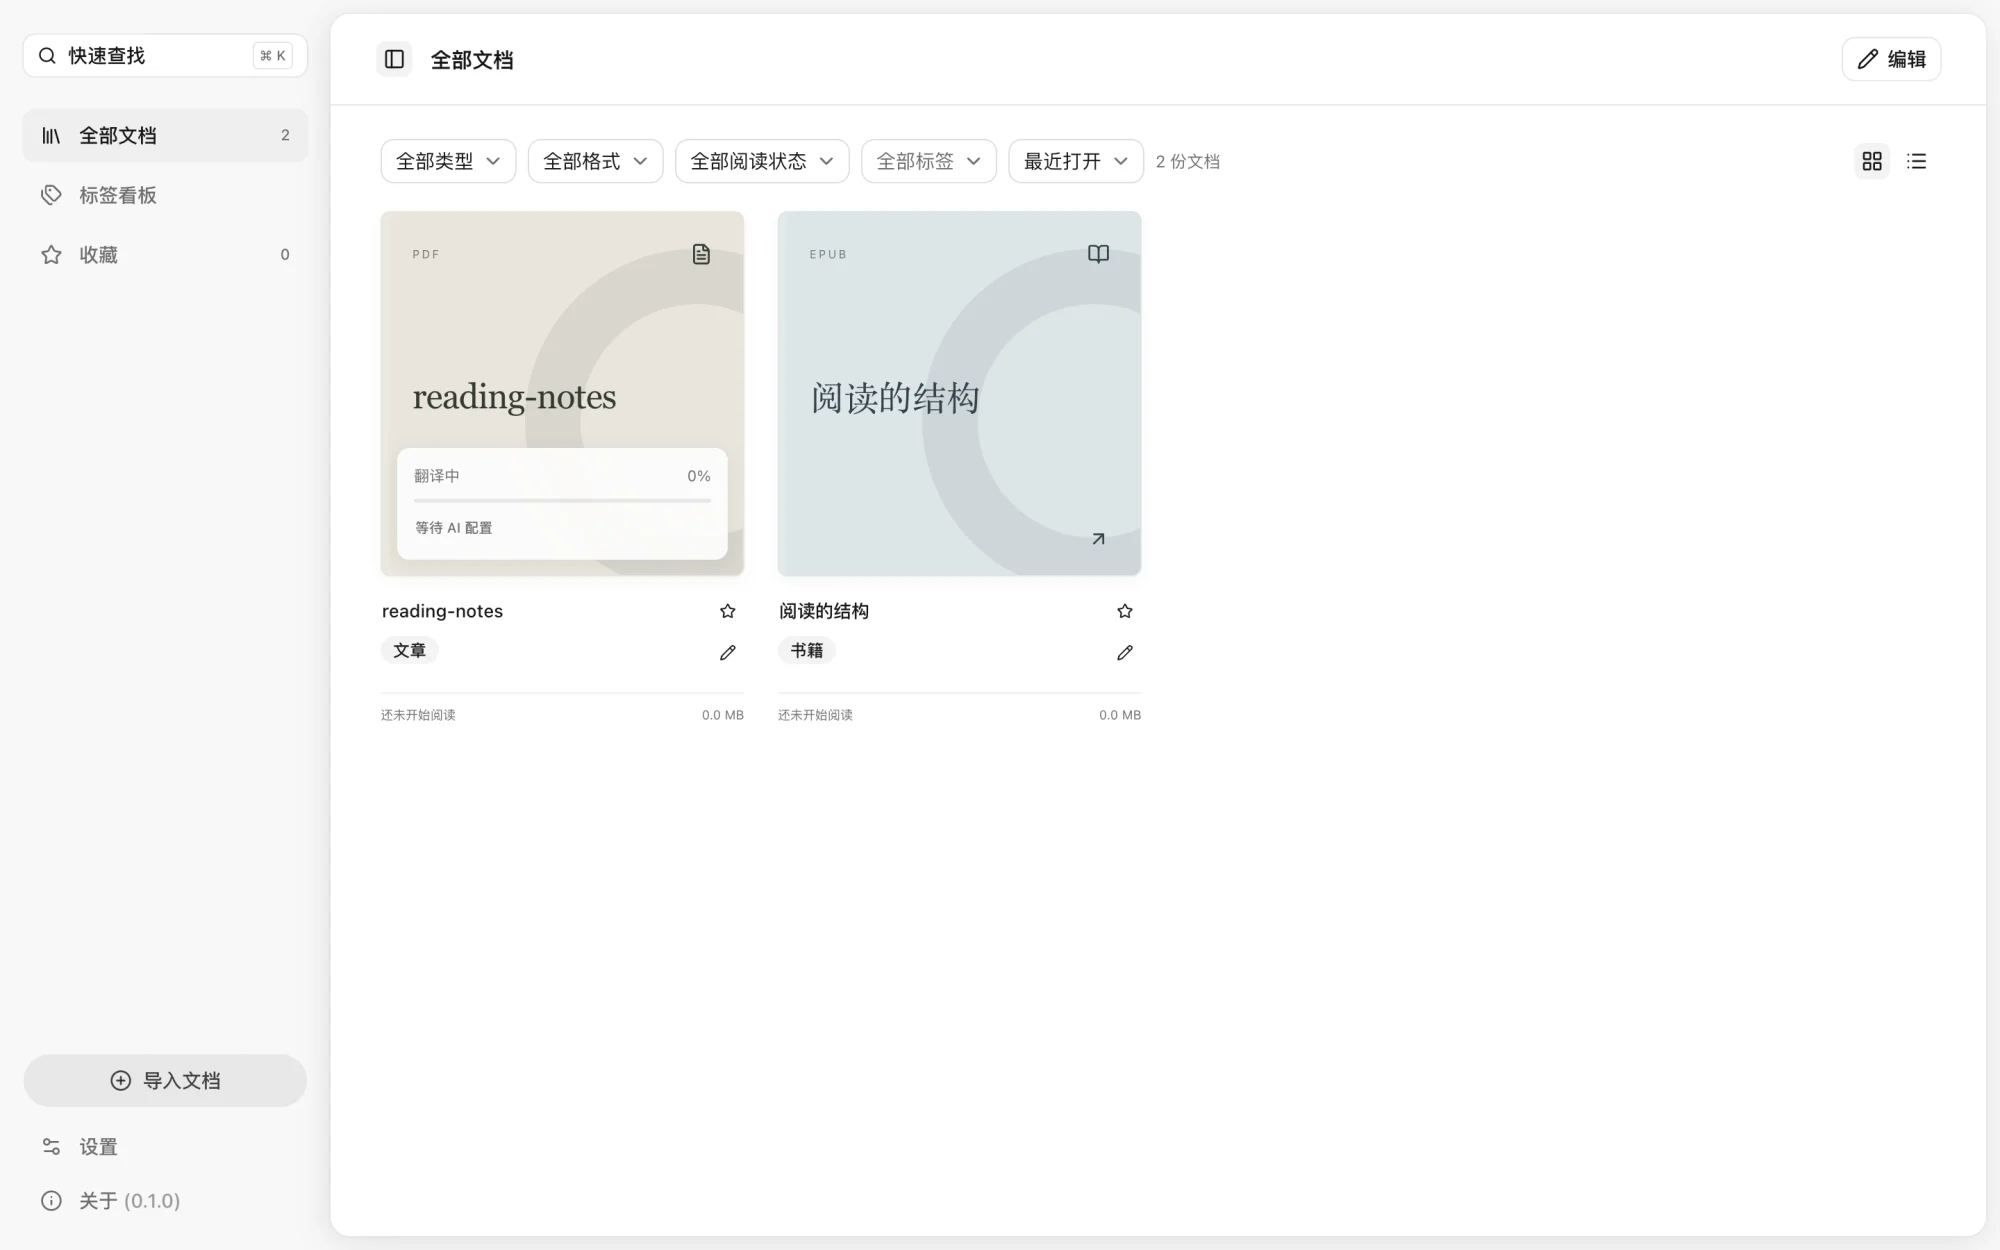
论文库:导入即整理
拖入 PDF,或粘贴 DOI、arXiv 编号、链接或标题导入;作者、年份与出处自动补全,不覆盖手动修改。支持嵌套分类、标签、阅读状态、表格视图与重复合并。
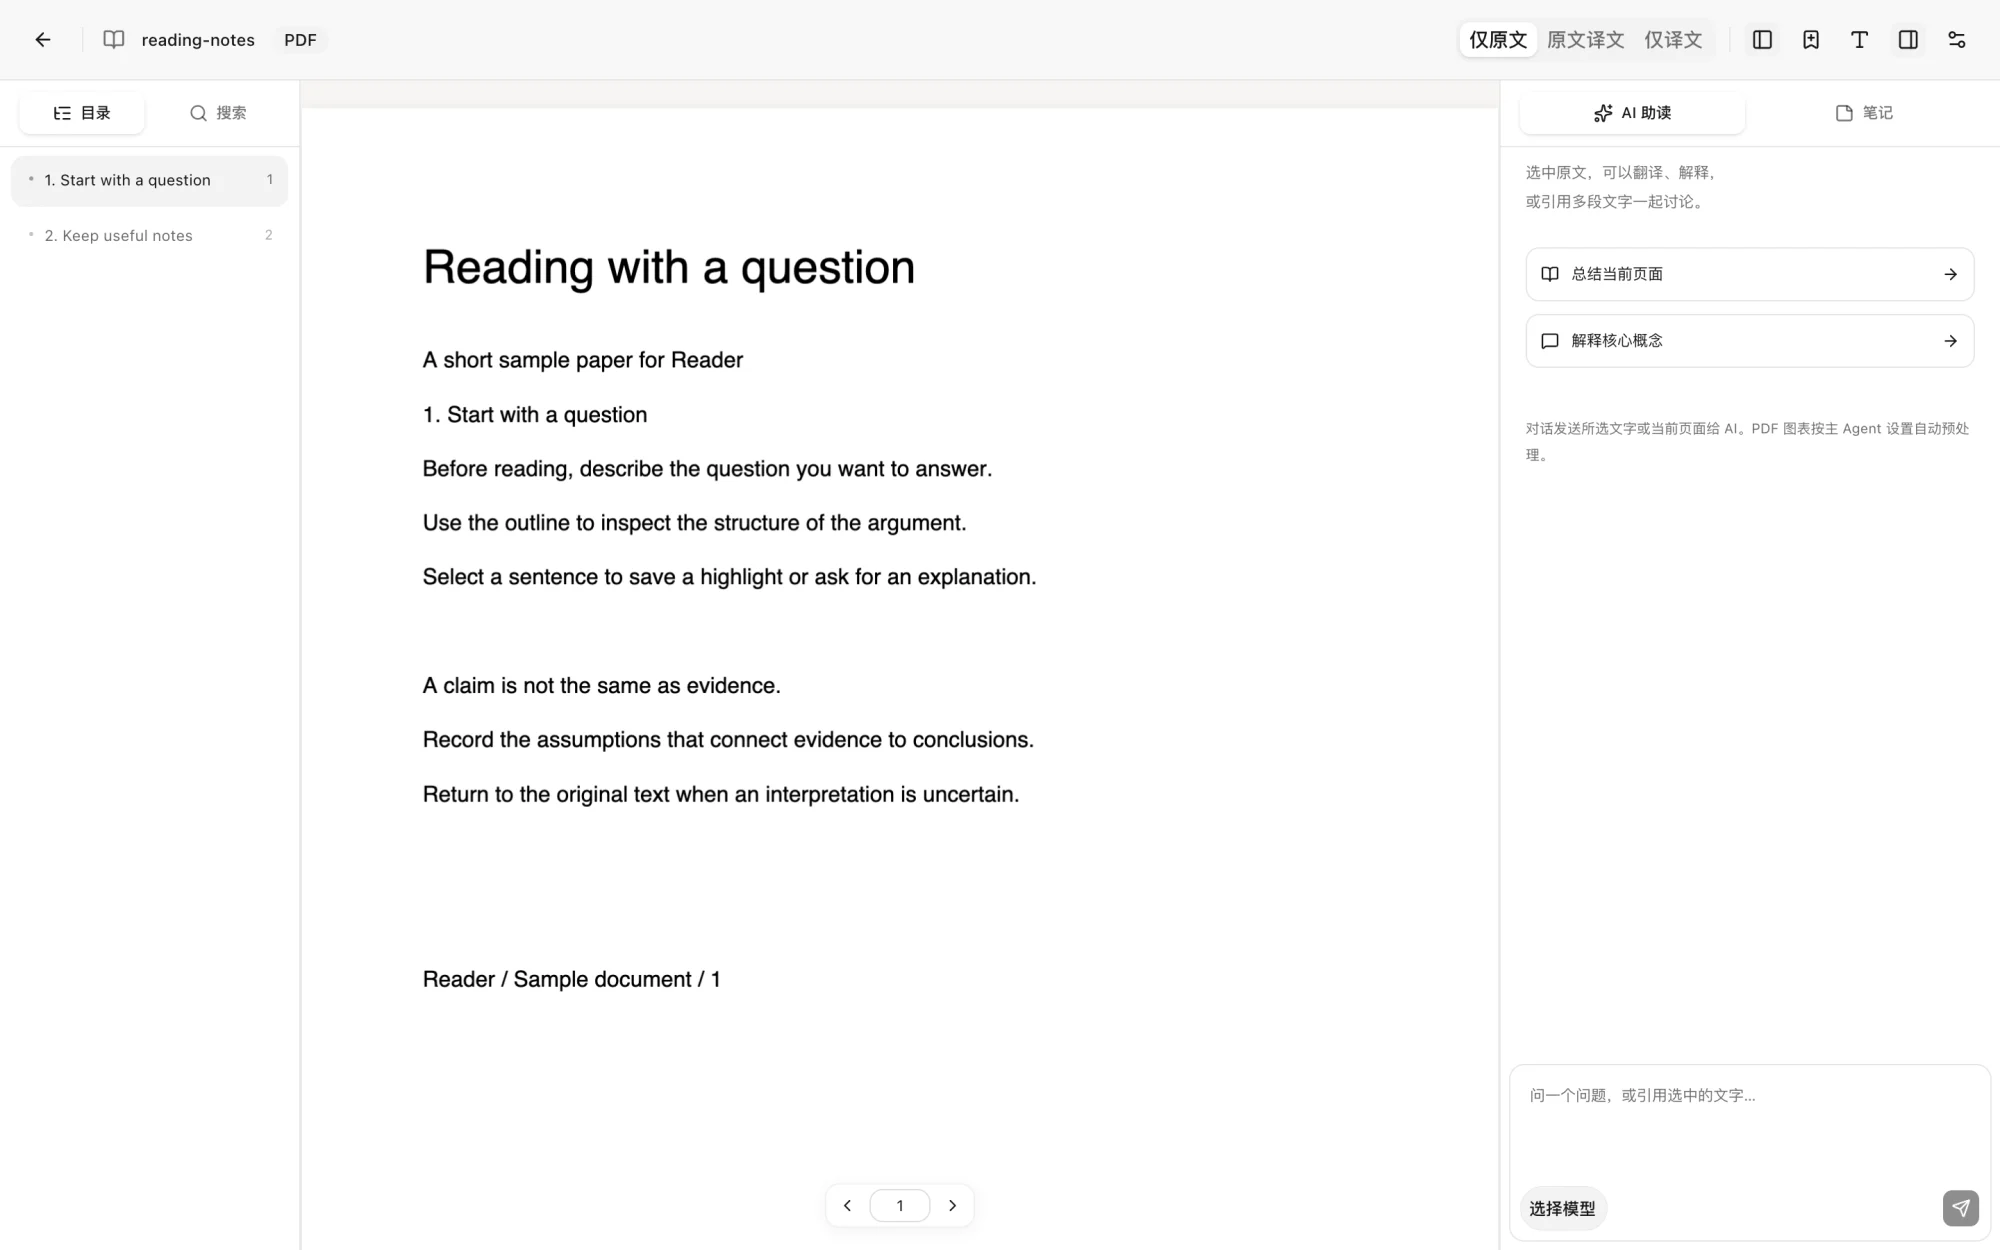
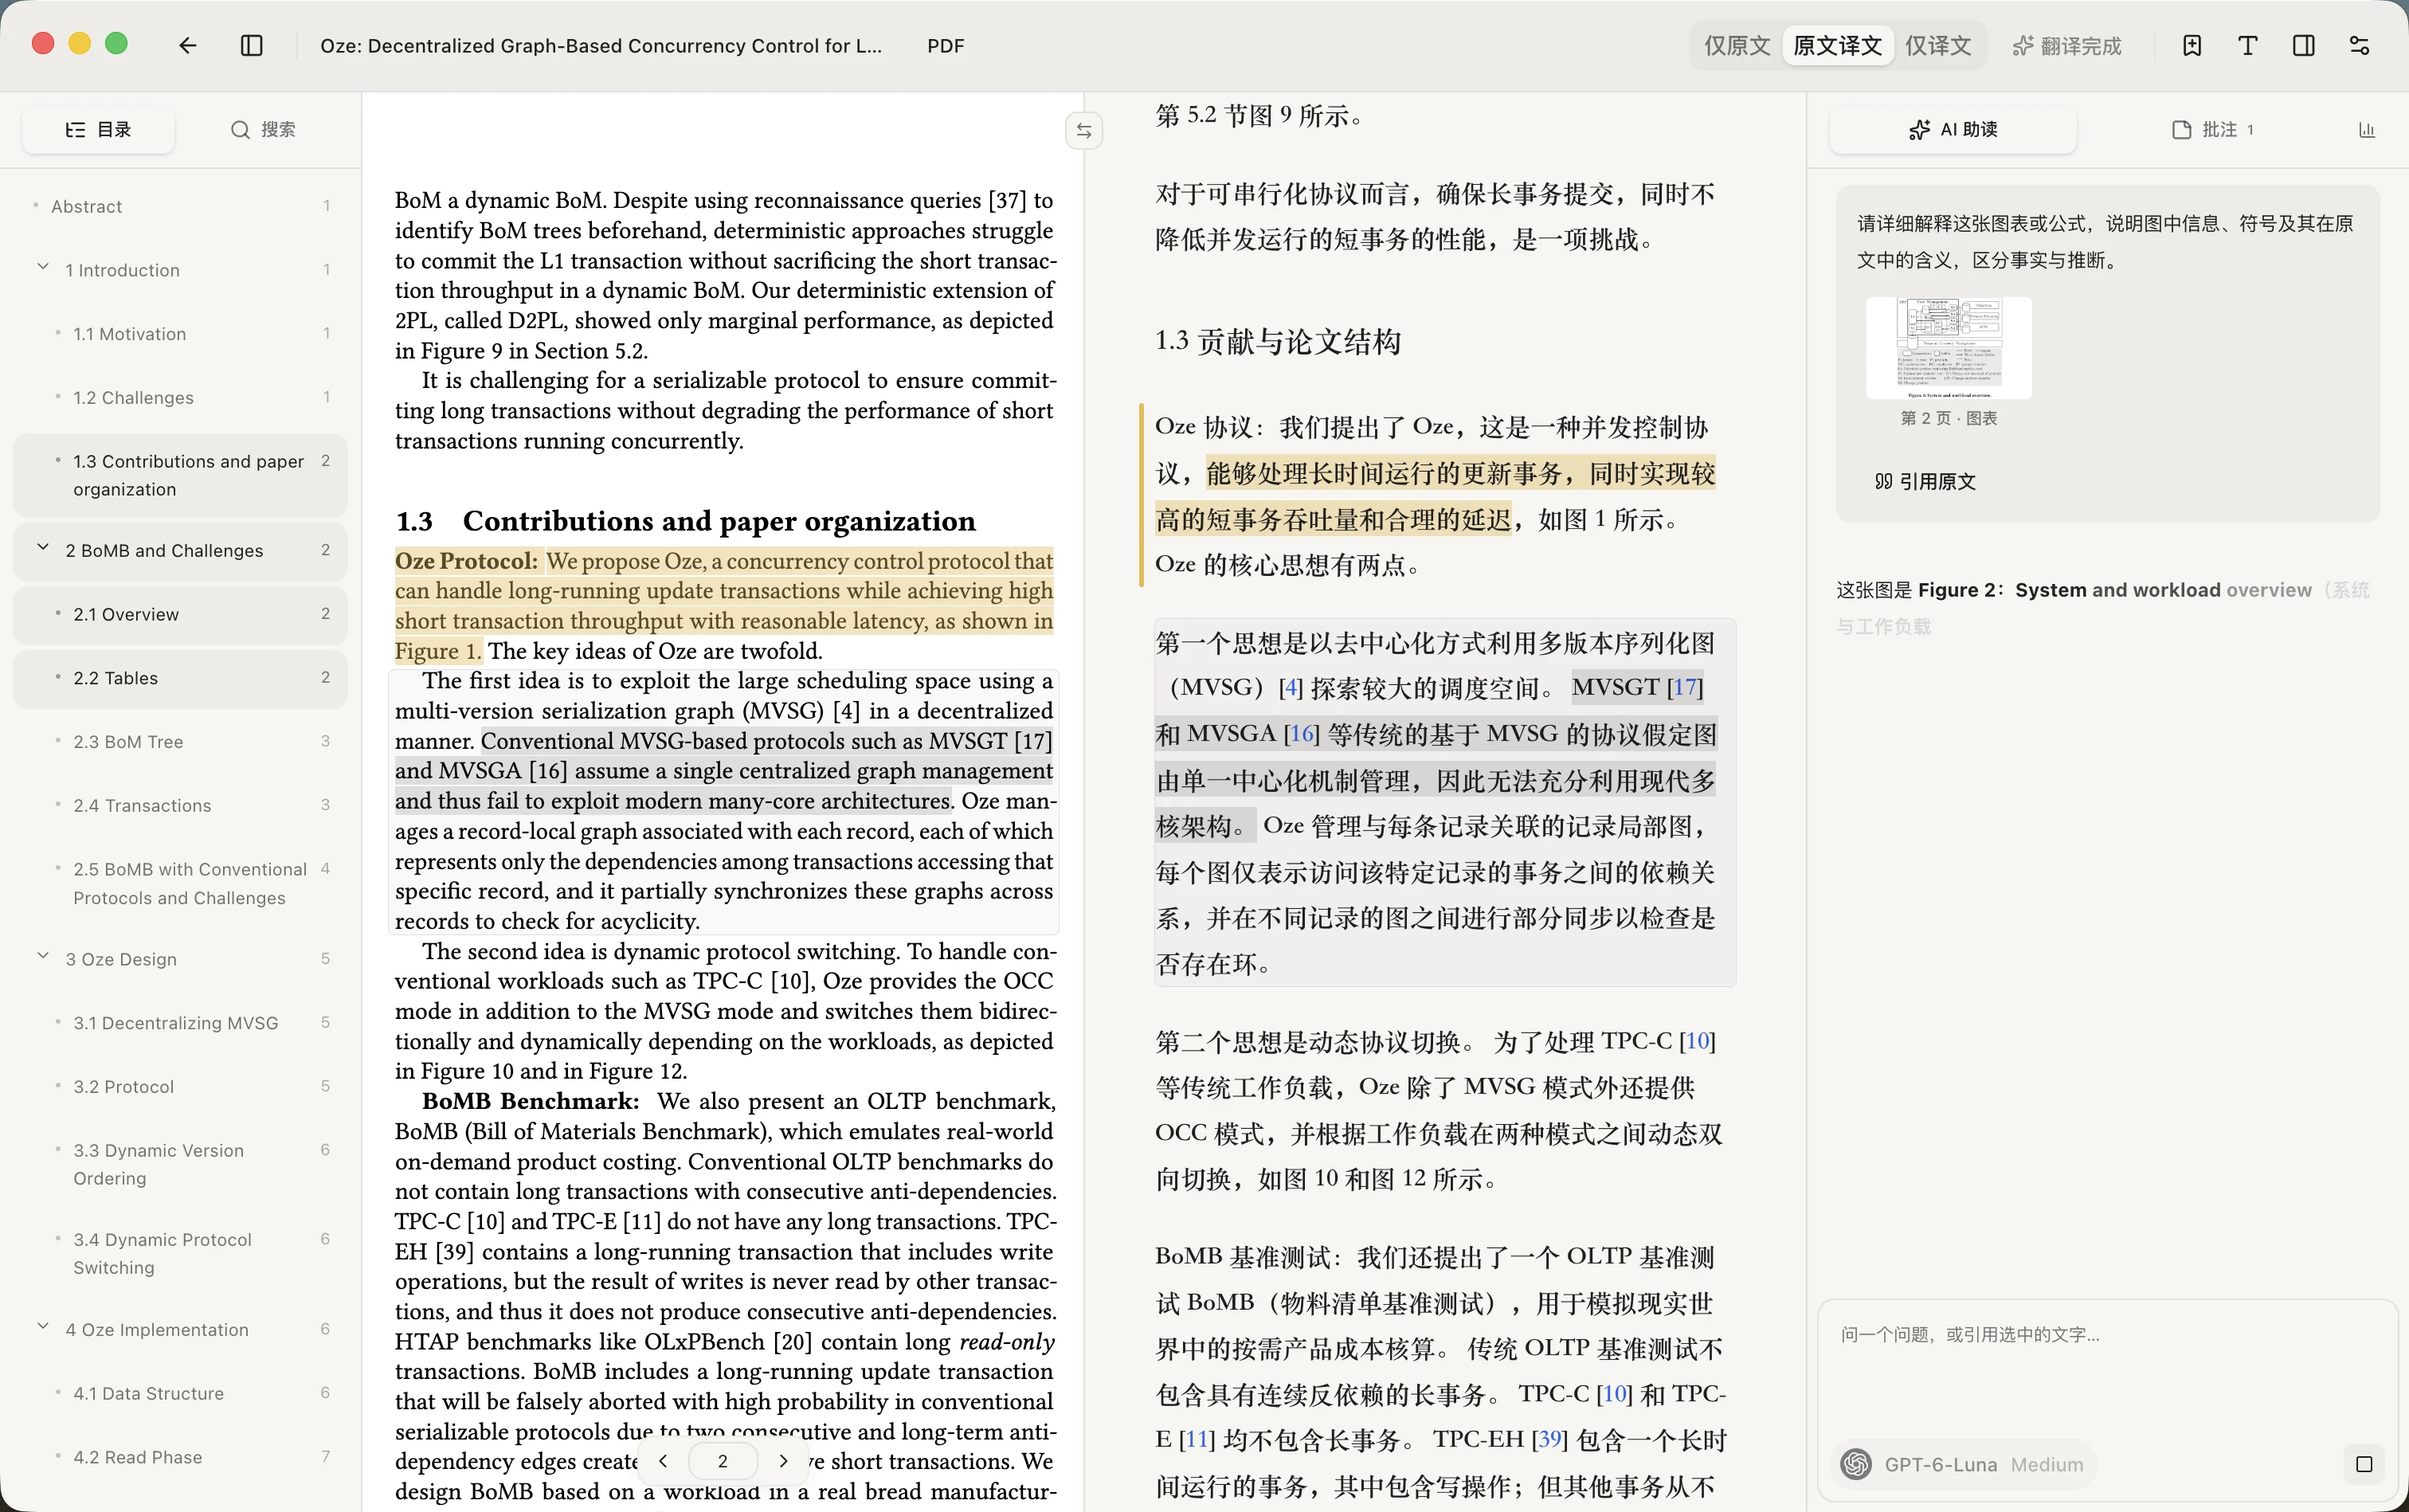
在原文上划线批注,与整篇译文对照阅读,带着上下文向 AI 提问。侧栏只在需要时展开。
Readers rarely move through a paper in a straight line. They skim the abstract, jump to a figure, and return to the method when a claim seems too strong. Each jump costs context: the reader has to remember where a statement came from before judging whether it holds.
Assistants that answer without the passage in view make this worse. A fluent summary can blur the line between what the authors claim and what their experiments show. We argue that every explanation should stay attached to the sentence that prompted it.
Translation raises the same problem. A side-by-side view helps only when each translated sentence can be traced to its source, so that a term can be checked against the original wording.
We make three contributions. First, we align source and translated text at the sentence level, so that hovering or selecting on either side marks the same span on the other. Second, we keep a reader's highlights, notes and questions anchored to positions in the original document. Third, we send the selected passage with each question, and link every answer back to it.
读者很少从头到尾按顺序读完一篇论文。他们会略读摘要、跳到某张图,在某个结论显得过强时再回到方法部分。每一次跳转都有上下文成本:判断一句话是否成立之前,读者必须记得它出自哪里。
脱离原文段落作答的助手会让情况更糟。流畅的总结可能模糊作者的主张与实验实际表明的内容之间的界线。我们认为,每一次解释都应当与引出它的那句原文保持关联。
翻译也面临同样的问题。只有当每个译句都能追溯到原句、术语可以与原文措辞核对时,对照阅读才真正有用。
本文有三点贡献。第一,我们在句子层面对齐原文与译文,在任一侧悬停或选中,另一侧都会标出同一段文字。第二,读者的高亮、批注和问题都锚定在原文中的位置上。第三,每次提问都会附上所选段落,每条回答都能链接回原文。
Reader 分论文库与图书库两种模式:论文库只收 PDF,按论文整理、翻译与引用;图书库放 EPUB 与长篇 PDF。下面以在论文库中读一篇 PDF 为例。
拖入 PDF,或粘贴 DOI、arXiv 编号、链接或标题导入;作者、年份与出处自动补全,不覆盖手动修改。支持嵌套分类、标签、阅读状态、表格视图与重复合并。
导入后先“学习”页面正文与版面,再“翻译”正文与图题。一次只显示一个阶段,完成后向上淡出;处理期间照常阅读。
本地版面模型识别正文、图表与公式;所选 Agent 逐段翻译正文和图题,公式转为 LaTeX。原文仍由 PDF.js 渲染,两侧悬停与划词按句对应,滚动保持同步。
PDF 按页搜索;EPUB 通过 SQLite FTS5 全文检索并支持字面子串匹配。
彩色高亮、下划线、问题与标签,可按颜色或标签筛选。摘录进论文笔记的批注带着回到原文的链接,在译文中划出的批注也关联原文位置。
复制单篇引用或批量导出,支持 GB/T 7714、APA、BibTeX 与 RIS。
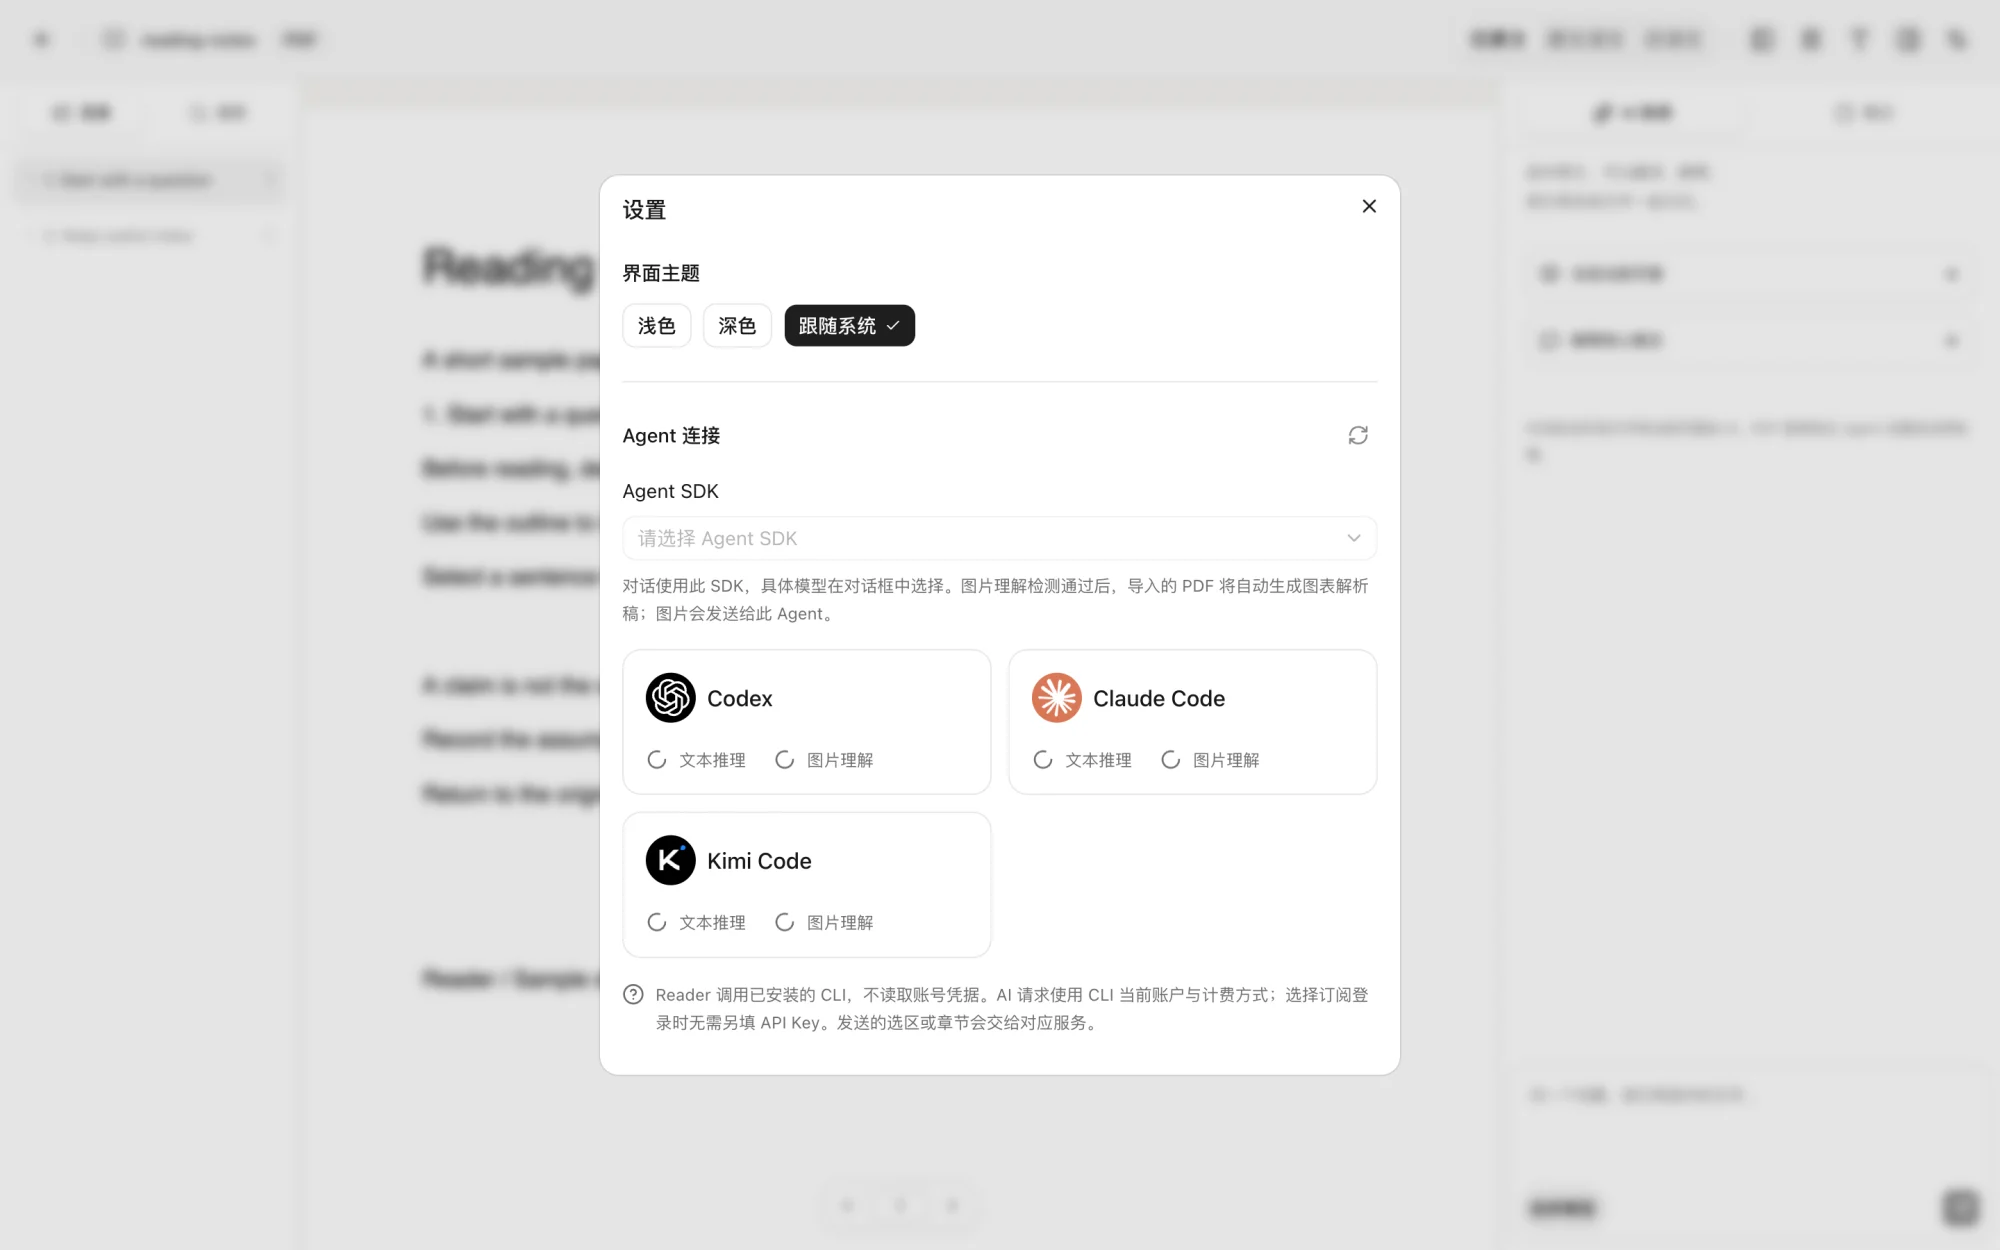
检测本机已安装的 CLI,用真实请求测试文本与识图能力;问答与翻译可分别选择模型。无需 API Key,不读取凭据文件。
在侧栏顶部切换,两库共用阅读界面,文档可随时在两库间移动。
界面、滚动条与原生窗口外观保持一致。
| 能力 | EPUB | |
|---|---|---|
| 所在书库 | 论文库或图书库 | 图书库 |
| 阅读引擎 | PDF.js Viewer | Readium Go Toolkit 解析,应用内渲染 |
| 导航 | 文档大纲,页码跳转 | 多级目录,章节跳转 |
| 排版 | 连续滚动,缩放,适合宽度 | 连续滚动,字号、字体、行距、页边距 |
| 翻译 | 导入后全文翻译(可关闭),含图题与公式 | 按章手动翻译 |
| 搜索 | 按页文本搜索 | SQLite FTS5,支持字面子串匹配 |
| AI 上下文 | 选区或当前页 | 选区或当前章节 |
以下截图来自应用本身,使用项目自带的示例文档。
有深色版本的截图会跟随本页外观切换。
原始文件存放在文件系统,论文信息、进度、批注、对话与设置存放在 SQLite。没有内置云同步。
下载安装包,或使用 Node.js 22+、pnpm 10 与 Go 1.26 从源码运行。
macOS(Apple Silicon)下载 DMG,Windows x64 下载 EXE。安装包没有开发者证书,首次打开需允许系统安全提示;之后可在应用内检查更新。
阅读、搜索与笔记都不需要 AI。想用 AI 助读时,用官方 CLI 登录即可。
把 PDF 拖入论文库、按 ⌘O,或用 DOI、arXiv 编号导入。超过 50 页的 PDF 会询问是否放入图书库。
不需要。Reader 调用你已登录的官方 Claude Code、Codex 或 Kimi CLI;权限、额度、模型与计费都跟随该 CLI 账户。
文档本身留在本机。启用主 Agent 后,导入 PDF 的正文与图题会发送翻译,公式图片会发送转换为 LaTeX,图表和表格不会发送;提问、解释或总结时,选区或当前章节 / 页面以及近期对话会经由 CLI 发送。论文信息补全只发送 DOI 或 arXiv 编号。
论文库只收 PDF,单个文件不超过 50 MB、150 页,提供论文信息、分类、标签、引用导出与全文翻译;图书库放 EPUB 与长篇 PDF,按章手动翻译。两库共用阅读界面,启动时进入哪个库可在设置中选择。
提供 macOS(Apple Silicon)与 Windows x64 安装包,均没有开发者证书;Windows 版尚未完成安装后的人工验收。暂不提供 Linux 安装包,可以从源码运行。
暂未实现 OCR,扫描页会被明确标注为文本不完整。目前主要面向带文本的 PDF 与无 DRM 的流式 EPUB。
首次分析会下载并校验约 67 MB 的版面模型,之后缓存在本地。不需要安装 Python 或 PaddlePaddle,重启后会继续处理。